Verified MethodologyPrimary Evidence 45% · Comparative Specs 30% · Community Consensus 25%
¿NVIDIA Blackwell vs. Google TPU v6e? Los 10 mejores chips y aceleradores para centros de datos de IA en 2026
Remixed from NVIDIA Blackwell vs. Google TPU v6e? Top 10 AI Datacenter Chips & Accelerators in 2026 by @admin
La infraestructura de IA de vanguardia en 2026 ya no es una carrera de una sola arquitectura. Si bien los chips Blackwell de NVIDIA y las TPUs de Google lideran la carga, otros contendientes como AMD,…
Read more
Microsoft y Cerebras están redefiniendo los límites del rendimiento y la eficiencia. Esta clasificación analiza los 10 principales chips y aceleradores de IA para centros de datos de 2026, evaluando su ancho de banda de memoria, capacidad de cómputo, escalabilidad y relación precio-rendimiento. ¿Quién se alzará con la victoria en esta batalla tecnológica? ¡Explora la lista y emite tu voto para decidir el campeón definitivo!
Top10Grid Editorial Studio

Starting order. Vote up or down to reorder this list.
Current Rankings
- #1 Top RankedLeader
El silicio Blackwell de NVIDIA, con sus dominios NVLink 5 de 72 GPU, establece el estándar para las fábricas de IA de vanguardia.
NVIDIA Blackwell redefine el rendimiento con su arquitectura de doble die y la integración de hasta 288 GB de memoria HBM3e. Los racks GB200 NVL72, con 72 GPUs unificadas, son ideales para cargas de trabajo de IA masivas.
Key Benchmarks & Specifications
Memoria y Ancho de Banda180–288 GB HBM3e8.0 TB/sCómputo Pico9 PFLOPS FP815–18 PFLOPS FP4Tejido de Escalado1.8 TB/s NVLink 5 (Dominio de 72 GPU)Fabricante y Proceso NVIDIA (TSMC4NP)Editorial Strengths & Watchouts
+ Strengths / Pros
- +Dominio NVLink 5 de 72 GPU para comunicación MoE
- +Hasta 288 GB HBM3e y 15 PFLOPS FP4 en Blackwell Ultra
− Watchouts / Trade-Offs
- −Requiere refrigeración líquida directa para racks GB200
- −Alto costo inicial y largos tiempos de entrega
Eligibility & Access
- Ideal para preentrenamiento de LLM de vanguardia
- Clústeres de razonamiento MoE de billones de parámetros
Key Caveats to Verify
- La refrigeración líquida es esencial para la densidad de potencia
- La inversión inicial es considerable
Vote: ¿Debería NVIDIA Blackwell ser el rey indiscutible de los aceleradores de IA?
La sexta generación de TPU de Google ofrece un cómputo 4.7 veces superior y una eficiencia de escalado del 99% en pods ópticos de 256 chips.
La Cloud TPU v6e de Google, conocida como Trillium, está diseñada para el ecosistema AI Hypercomputer de Google. Ofrece un cómputo masivo y una eficiencia de escalado excepcional, ideal para entrenamiento de modelos a gran escala.
Key Benchmarks & Specifications
Memoria y Ancho de Banda32 GB HBM1,638 GB/s por ChipCómputo Pico918 TFLOPS BF16/FP81,836 TOPS INT8Tejido de Escalado800 GB/s ICIPod Torus 2D de 256 ChipsEditorial Strengths & Watchouts
+ Strengths / Pros
- +Eficiencia de escalado del 99% en pods multi-pod ICI
- +Mejor rendimiento por dólar en entrenamiento de LLM
− Watchouts / Trade-Offs
- −Exclusivamente disponible en Google Cloud
- −La HBM de 32 GB requiere fragmentación temprana de tensores
Eligibility & Access
- Ideal para equipos JAX, PyTorch/XLA y GKE
- Optimización de entrenamiento en la nube y multi-instancia
Key Caveats to Verify
- Acceso limitado a la nube de Google
- Menor capacidad de memoria por chip
Vote: ¿Debería la TPU v6e de Google ser la alternativa principal a NVIDIA?
El MI355X de AMD, con chiplets CDNA 4 de 3nm y 288 GB de HBM3e, es el principal rival abierto de NVIDIA Blackwell.
El AMD Instinct MI355X, basado en la arquitectura CDNA 4, combina chiplets de 3nm con una gran capacidad de memoria HBM3e. Es una opción potente para quienes buscan un ecosistema abierto y un rendimiento de vanguardia.
Key Benchmarks & Specifications
Memoria y Ancho de Banda288 GB HBM3e8.0 TB/sCómputo Pico10.1 PFLOPS MXFP4 y MXFP6Tejido de Escalado7× Enlaces Infinity Fabric (2.3 TB OAM de 8 GPU)Fabricante y Proceso AMD (TSMC3nm / 6nm CDNA 4)Editorial Strengths & Watchouts
+ Strengths / Pros
- +Enorme capacidad HBM3e de 288 GB por servidor de 8 GPU
- +Núcleos de matriz CDNA 4 de 3nm con precisión MXFP4/MXFP6
− Watchouts / Trade-Offs
- −Infinity Fabric limitado a 8 GPUs por chasis OAM
- −Requiere refrigeración de alta capacidad por su consumo
Eligibility & Access
- Ideal para Hiperescaladores y nubes soberanas
- Empresas que buscan alternativas abiertas a CUDA
Key Caveats to Verify
- La escala Infinity Fabric es por nodo de 8 GPUs
- Alto consumo energético por placa
Vote: ¿Es el AMD Instinct MI355X la mejor opción para un ecosistema de IA abierto?
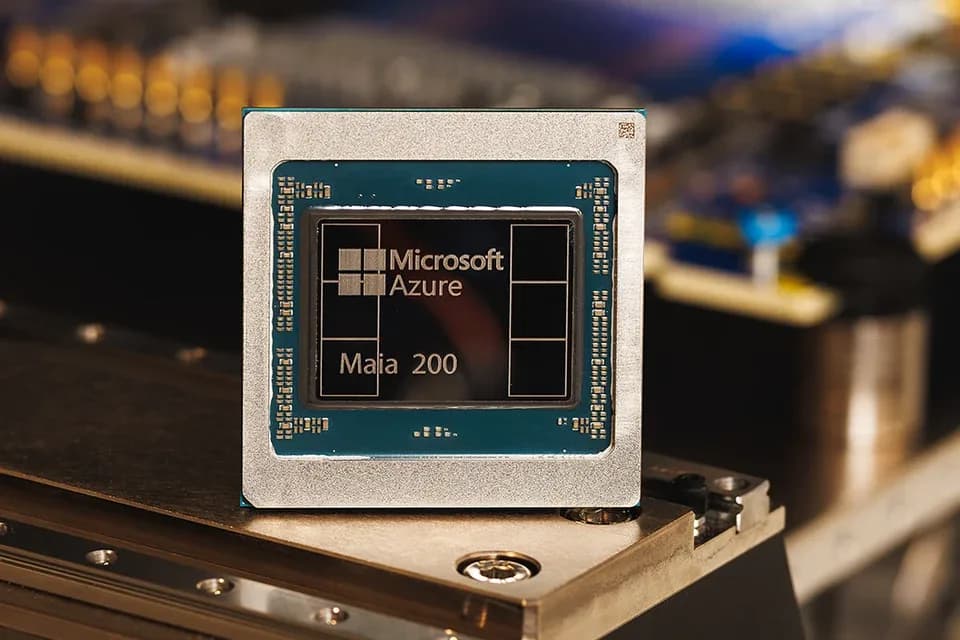
Maia 200 de Azure, fabricado en TSMC 3nm, ofrece un 30% más de rendimiento por dólar en Azure.
El Maia 200 de Microsoft es un chip de IA personalizado diseñado para la nube Azure. Destaca por su eficiencia energética y su capacidad para escalar a miles de aceleradores, optimizado para tareas de inferencia.
Key Benchmarks & Specifications
Memoria y Ancho de Banda216 GB HBM3e (7 TB/s) + 272 MB SRAMCómputo Pico10.1 PetaOPS FP45+ PFLOPS FP8Tejido de Escalado2.8 TB/s ATL Ethernet On-Die (6,144 Chips)Fabricante y Proceso Microsoft Azure (TSMC N3)Editorial Strengths & Watchouts
+ Strengths / Pros
- +216 GB HBM3e y SRAM en un envolvente de 750W
- +NIC Ethernet integrada de 2.8 TB/s para escalado masivo
− Watchouts / Trade-Offs
- −Restringido a regiones de Microsoft Azure
- −Arquitectura enfocada en inferencia, no en entrenamiento
Eligibility & Access
- Ideal para cargas de trabajo de inferencia en Azure
- Equipos que buscan optimizar el rendimiento por dólar
Key Caveats to Verify
- Disponibilidad limitada a la nube Azure
- Menos versátil para entrenamiento intensivo
Vote: ¿Debería Azure Maia 200 ser el estándar para la inferencia de IA en la nube?
Los UltraServidores Trainium2 de 64 chips de AWS conectan 6 TB de HBM3 y 185 TB/s de ancho de banda.
AWS Trainium2, la segunda generación de aceleradores de Annapurna Labs, está diseñada para el entrenamiento de modelos de IA a gran escala en la nube de AWS. Sus configuraciones UltraServer ofrecen una potencia de cómputo y memoria combinadas masivas.
Key Benchmarks & Specifications
Memoria y Ancho de Banda96 GB HBM32.9 TB/s por Chip (6 TB UltraServer)Cómputo Pico1.3 PFLOPS FP8 (83.2 PFLOPS / Servidor de 64 Chips)Tejido de Escalado NeuronLink (64 Chips) +12.8 Tbps EFAv3Fabricante y Proceso #5AWS Annapurna LabsEditorial Strengths & Watchouts
+ Strengths / Pros
- +Servidores UltraServer de 64 chips con 6 TB HBM3 y 185 TB/s
- +Red EFAv3 de 12.8 Tbps para escalado masivo
− Watchouts / Trade-Offs
- −Requiere compilación con el SDK AWS Neuron
- −La HBM3 por chip es inferior a las HBM3e actuales
Eligibility & Access
- Ideal para entrenamiento nativo en AWS
- Modelos fundacionales y cargas de trabajo de Claude
Key Caveats to Verify
- Dependencia del ecosistema AWS Neuron SDK
- Menor memoria por chip comparado con competidores
Vote: ¿Es Trainium2 la mejor opción para el entrenamiento de IA en AWS?
La H200 de NVIDIA, con 141 GB de HBM3e, es la actualización ideal para centros de datos empresariales existentes.
La NVIDIA H200 Tensor Core GPU mejora la arquitectura Hopper con una mayor capacidad de memoria HBM3e y ancho de banda. Es una opción sólida para empresas que buscan actualizar sus infraestructuras de IA sin grandes cambios.
Key Benchmarks & Specifications
Memoria y Ancho de Banda141 GB HBM3e4.8 TB/sCómputo Pico3,958 TFLOPS FP8 / INT8 (SXM)Tejido de Escalado900 GB/s NVLink 4 (SXM)1.8 TB/s NVL de 4 VíasFabricante y Proceso NVIDIA (TSMC4N Hopper)Editorial Strengths & Watchouts
+ Strengths / Pros
- +Compatibilidad directa con racks HGX H100 existentes
- +Gran capacidad de memoria para modelos grandes y lotes KV
− Watchouts / Trade-Offs
- −Carece de núcleos Tensor FP4 de hardware
- −Menor ancho de banda de memoria que las HBM3e actuales
Eligibility & Access
- Ideal para expandir clústeres de IA on-premise refrigerados por aire
- Necesidad de capacidad multi-nube inmediata
Key Caveats to Verify
- Ausencia de soporte FP4 nativo
- Ancho de banda de memoria inferior a las últimas generaciones
Vote: ¿Es la NVIDIA H200 la mejor opción para actualizar centros de datos existentes?
El WSE-3 de Cerebras, con 4 billones de transistores en una oblea, alcanza velocidades de token SRAM de petabytes por segundo.
El Cerebras Wafer-Scale Engine 3 (WSE-3) es un chip masivo que abarca una oblea completa de silicio, integrando billones de transistores y una gran cantidad de núcleos de IA. Está diseñado para eliminar los cuellos de botella de memoria en cargas de trabajo de IA.
Key Benchmarks & Specifications
Memoria y Ancho de Banda44 GB SRAM en Oblea21–43.2 PB/sCómputo Pico125 PFLOPS (WSE-3)250 PFLOPS (WSE-3 Turbo)Tejido de Escalado Chip Único de46,225 mm² (Tejido en Oblea de 53.5 PB/s)Fabricante y Proceso Cerebras Systems (Oblea TSMC5nm)Editorial Strengths & Watchouts
+ Strengths / Pros
- +Ancho de banda SRAM en oblea de 21–43.2 PB/s
- +Modelo de programación de dispositivo único simplificado
− Watchouts / Trade-Offs
- −La SRAM de 44 GB requiere clústeres multi-sistema para modelos grandes
- −Formato de electrodoméstico CS-3 / CS-4 propietario
Eligibility & Access
- Ideal para razonamiento ultra-rápido y modelos de agentes
- Cargas de trabajo que se benefician de un ancho de banda de memoria extremo
Key Caveats to Verify
- La capacidad de SRAM requiere streaming de memoria para modelos masivos
- No es un formato de servidor estándar
Vote: ¿Es la escala de oblea de Cerebras el futuro de los aceleradores de IA?
La LPU de Groq, con su programación determinista y SRAM de 80-150 TB/s, es el referente de latencia para IA en tiempo real.
La Unidad de Procesamiento de Lenguaje (LPU) de Groq está diseñada para un rendimiento determinista y de baja latencia, ideal para el procesamiento del lenguaje natural y aplicaciones de IA de agentes. Su arquitectura única se complementa con la tecnología LPX de NVIDIA.
Key Benchmarks & Specifications
Memoria y Ancho de Banda230 MB–500 MB SRAM en Chip80–150 TB/sCómputo Pico #8Tensor/Vector Programado por Compilador DeterministaTejido de Escalado Plesiócrono Chip-a-Chip / Rack LPX de256 LPUsFabricante y Proceso #8Editorial Strengths & Watchouts
+ Strengths / Pros
- +Ejecución determinista garantiza latencia sub-milisegundo
- +Ancho de banda SRAM interno de 80-150 TB/s para decodificación rápida
− Watchouts / Trade-Offs
- −La SRAM de 230-500 MB requiere cientos de LPUs para modelos grandes
- −Estrictamente un motor de inferencia, sin capacidad de entrenamiento
Eligibility & Access
- Ideal para especialistas en decodificación en racks disociados
- Aplicaciones de IA conversacional y agentes
Key Caveats to Verify
- Requiere muchos chips para modelos grandes
- No apto para entrenamiento de modelos fundacionales
Vote: ¿Es la LPU de Groq la solución definitiva para la IA de baja latencia?
El Gaudi 3 de Intel integra 24 NICs RoCEv2 de 200 GbE para escalado Ethernet abierto.
El Intel Gaudi 3 es un acelerador de IA diseñado para el entrenamiento eficiente de modelos. Combina una alta capacidad de memoria HBM2e con puertos Ethernet integrados, facilitando el escalado en centros de datos empresariales.
Key Benchmarks & Specifications
Memoria y Ancho de Banda128 GB HBM2e + 96 MB SRAM3.7 TB/sCómputo Pico1.8 PFLOPS FP8 y BF16Tejido de Escalado24× Ethernet RoCEv2 Integrada de 200 GbEFabricante y Proceso Intel / Habana Labs (TSMC5nm)Editorial Strengths & Watchouts
+ Strengths / Pros
- +24 puertos RoCEv2 de 200 GbE eliminan switches propietarios
- +Tarjetas PCIe HL-338 de 600W compatibles con servidores estándar
− Watchouts / Trade-Offs
- −Ancho de banda HBM2e (3.7 TB/s) y FP8 (1.8 PFLOPS) inferiores a los HBM3e
- −Comunidad de desarrolladores de terceros más pequeña que CUDA o ROCm
Eligibility & Access
- Ideal para empresas conscientes del costo en RAG y fine-tuning
- Entrenamiento de LLMs de código abierto
Key Caveats to Verify
- Menor ancho de banda de memoria y cómputo pico
- Menor adopción por desarrolladores externos
Vote: ¿Es el Intel Gaudi 3 la mejor opción de IA para empresas con presupuesto limitado?
El MTIA v2 de Meta, con solo 90W TDP y un compilador Triton-MTIA, demuestra la eficiencia de silicio personalizado para el ranking.
El Next-Gen MTIA v2 de Meta es un chip diseñado a medida para las flotas de inferencia e recomendación de Meta. Destaca por su ultraeficiencia energética y su integración con el ecosistema de software de Meta, siendo clave para sus operaciones a hiperescala.
Key Benchmarks & Specifications
Memoria y Ancho de Banda256 MB SRAM en Chip (2.7 TB/s) + 128 GB LPDDR5Cómputo Pico708 TFLOPS INT8 (Disperso)354 TFLOPS BF16Tejido de Escalado Malla PCIe Gen5 + RDMA Scale-Out (Rack de72 Aceleradores)Fabricante y Proceso Infraestructura Meta (TSMC5nm)Editorial Strengths & Watchouts
+ Strengths / Pros
- +Ultraeficiente TDP de 90W para 72 aceleradores en un rack
- +SRAM en chip de 2.7 TB/s para alta utilización en inferencia
− Watchouts / Trade-Offs
- −Silicio interno de Meta no disponible para clientes externos
- −LPDDR5 de 204.8 GB/s enfocado en ranking y inferencia media
Eligibility & Access
- Ideal para la eficiencia de hiperescala en Meta
- Cargas de trabajo de ranking y recomendación
Key Caveats to Verify
- No disponible para compra externa
- Menor ancho de banda externo para cargas de trabajo muy grandes
Vote: ¿Debería Meta hacer el MTIA v2 accesible para otros?
Have a list idea?
Start your own list and get help drafting entries with AI. A free account is required.
Create a list with AI →Think something was robbed of a spot?
Nominate a missing contender — once approved, the community votes it up or down into the rankings.
Metodología del Ranking y Criterios de Evaluación
Nuestra metodología se centra en métricas clave que definen el rendimiento de los aceleradores de IA en entornos de centros de datos. Priorizamos el Ancho de Banda de Memoria y Cómputo, el Tejido de Escalado de Clúster para la comunicación entre chips, la madurez del Ecosistema de Software para la compatibilidad y facilidad de uso, y la Relación Precio-Rendimiento/Vatios para la eficiencia general. Además de estos criterios técnicos, la clasificación tiene en cuenta la opinión de la comunidad. Tus votos y participaciones ayudan a refinar las posiciones, asegurando que la lista refleje tanto la innovación tecnológica como la preferencia del usuario. Cada voto contribuye a una visión más completa del panorama de los aceleradores de IA.
Image credits
- NVIDIA Blackwell B200 y GB200 NVL72: dailyanimeart.com
- Google Cloud TPU v6e (Trillium): Visitor7 (CC BY-SA 3.0)
- AMD Instinct MI355X: Festival Internacional de Cine en Guadalajara (CC BY 2.0)
- Microsoft Azure Maia 200: Microsoft Azure (TSMC N3) Official Hardware Press Release
- AWS Trainium2 (EC2 Trn2 UltraServer): circuitdiagram.co
- GPU NVIDIA H200 Tensor Core: youtube.com
- Cerebras Wafer-Scale Engine 3 (WSE-3 / WSE-3T): payhip.com
- Groq LPU y NVIDIA Groq 3 LPX: rawpixel.com
- Acelerador de IA Intel Gaudi 3: Raimond Spekking (CC BY-SA 4.0)
- Meta Next-Gen MTIA v2: smial (talk) (FAL)
Rank it your way
Remix this list into your own ranking, or head to the play hub for every game mode and community breakdown — blind mode, challenges, tier lists, and more.