Verified MethodologyPrimary Evidence 45% · Comparative Specs 30% · Community Consensus 25%
NVIDIA Blackwell ضد Google TPU v6e؟ أفضل 10 شرائح ومسرعات مراكز بيانات الذكاء الاصطناعي لعام 2026
Remixed from NVIDIA Blackwell vs. Google TPU v6e? Top 10 AI Datacenter Chips & Accelerators in 2026 by @admin
في عام 2026، لم تعد البنية التحتية المتطورة للذكاء الاصطناعي سباقًا معماريًا واحدًا. بينما تجمع شرائح Blackwell من NVIDIA و TPU v6e من Google بين ذاكرة HBM3e الهائلة وقدرات معالجة فائقة، يظهر منافسون جدد مثل AMD و…
Read more
Microsoft و Cerebras بقوة. لقد قمنا بتقييم أفضل 10 شرائح ومسرعات لمراكز بيانات الذكاء الاصطناعي لعام 2026 بناءً على معايير صارمة تشمل عرض النطاق الترددي للحوسبة والذاكرة، وقابلية التوسع، ونضج النظام البيئي البرمجي، والأداء مقابل السعر. اكتشف أي التقنيات تتصدر المشهد وقم بالتصويت لمفضلتك.
Top10Grid Editorial Studio

Starting order. Vote up or down to reorder this list.
Current Rankings
- #1 Top RankedLeader
رقاقة ثنائية بحجم 208 مليار ترانزستور مع نطاقات NVLink 5 بـ 72 وحدة معالجة رسوميات تجعل Blackwell المعيار المطلق لمصانع الذكاء الاصطناعي المتطورة.
تدمج NVIDIA Blackwell شريحتي TSMC 4NP مع رابط NV-HBI بسرعة 10 تيرابايت/ثانية، مما يوفر ما يصل إلى 288 جيجابايت من ذاكرة HBM3e. في وحدات GB200 NVL72 المبردة بالسائل، تعمل 72 وحدة معالجة رسوميات كوحدة معالجة واحدة ضخمة متماسكة الذاكرة.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي180–288 جيجابايت HBM3e8.0 تيرابايت/ثانيةالحوسبة القصوى 9 بيتا فلوبس FP815–18 بيتا فلوبس FP4قابلية التوسع 1.8 تيرابايت/ثانية NVLink 5 (نطاق 72 وحدة معالجة رسوميات)الشركة المصنعة والمعالجة NVIDIA (TSMC 4NP)Editorial Strengths & Watchouts
+ Strengths / Pros
- +نطاق NVLink 5 بـ 72 وحدة معالجة رسوميات يتغلب على اختناقات الاتصال
- +ذاكرة HBM3e تصل إلى 288 جيجابايت و 15 بيتا فلوبس FP4
− Watchouts / Trade-Offs
- −تتطلب وحدات NVL72 تبريدًا سائلًا مباشرًا
- −أعلى تكلفة أولية وأطول فترات تسليم
Eligibility & Access
- مثالية لتدريب نماذج اللغة الكبيرة المتطورة
- مناسبة لتجميعات الاستدلال لنماذج التريليونات من المعلمات
Key Caveats to Verify
- تتطلب بنية تحتية متخصصة للتبريد
- تكاليف استثمارية أولية مرتفعة
Vote: هل تعتقد أن Blackwell هو الأفضل؟
توفر TPU v6e من الجيل السادس من Google 4.7x قوة حوسبة قصوى وكفاءة توسع بنسبة 99% عبر وحدات بود بصرية بـ 256 شريحة.
تم تصميم Cloud TPU v6e (Trillium) خصيصًا لمكدس Google AI Hypercomputer، وتوفر قوة حوسبة تبلغ 918 تيرافلوبس لكل شريحة وعرض نطاق ترددي للذاكرة يبلغ 1638 جيجابايت/ثانية. تتوسع عبر وحدات بود ثنائية الأبعاد بـ 256 شريحة بكفاءة توسع عالية.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي32 جيجابايت HBM1,638 جيجابايت/ثانية لكل شريحةالحوسبة القصوى 918 تيرافلوبس BF16/FP81,836 تيرا عمليات INT8قابلية التوسع 800 جيجابايت/ثانية ICIبود ثنائي الأبعاد بـ 256 شريحةEditorial Strengths & Watchouts
+ Strengths / Pros
- +كفاءة توسع مثبتة بنسبة 99% عبر شبكات ICI البصرية متعددة البودات
- +قفزة في قوة الحوسبة القصوى 4.7x مقارنة بـ TPU v5e
− Watchouts / Trade-Offs
- −متوفرة حصريًا على Google Cloud فقط
- −ذاكرة HBM بسعة 32 جيجابايت لكل شريحة تتطلب تجزئة أسرع للموتر
Eligibility & Access
- مثالية لفرق JAX و PyTorch/XLA و GKE
- مناسبة لتحسين التدريب السحابي وعمليات الاستدلال عالية الإنتاجية
Key Caveats to Verify
- الاعتماد الكامل على بيئة Google Cloud
- سعة ذاكرة أقل لكل شريحة مقارنة بالمنافسين
Vote: هل تعتقد أن TPU v6e هو الأفضل؟
بنيت على شرائح CDNA 4 بدقة 3 نانومتر مع 288 جيجابايت من ذاكرة HBM3e بسرعة 8 تيرابايت/ثانية، MI355X هي المنافس الرئيسي المفتوح لـ NVIDIA Blackwell.
تجمع AMD Instinct MI355X بين شرائح TSMC 3 نانومتر وذاكرة HBM3e بسعة 288 جيجابايت وعرض نطاق ترددي 8 تيرابايت/ثانية. توفر قاعدة لوحة OAM بـ 8 وحدات معالجة رسوميات ذاكرة متماسكة بسعة 2.3 تيرابايت، مما يسمح بنماذج تتجاوز 400 مليار معلمة.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي288 جيجابايت HBM3e8.0 تيرابايت/ثانيةالحوسبة القصوى 10.1 بيتا فلوبس MXFP4 و MXFP6قابلية التوسع 7 روابط Infinity Fabric (2.3 تيرابايت 8 وحدات معالجة رسوميات OAM)الشركة المصنعة والمعالجة AMD (TSMC 3 نانومتر / 6 نانومتر CDNA 4)Editorial Strengths & Watchouts
+ Strengths / Pros
- +سعة ذاكرة HBM3e ضخمة تبلغ 288 جيجابايت تقلل عدد العقد لنماذج LLM الكبيرة
- +دعم مفتوح لـ ROCm و Triton و vLLM يتجنب الاعتماد على CUDA
− Watchouts / Trade-Offs
- −شبكة Infinity Fabric تمتد عبر 8 وحدات معالجة رسوميات لكل هيكل OAM
- −تتطلب طاقة لوحة عالية التبريد السائل أو الهجين
Eligibility & Access
- مثالية لمقدمي الخدمات السحابية الكبرى والشركات
- مناسبة للبيئات التي تتطلب سعة ذاكرة كبيرة
Key Caveats to Verify
- نطاق التوسع محدود بـ 8 وحدات معالجة رسوميات لكل عقدة
- متطلبات تبريد عالية
Vote: هل تعتقد أن MI355X هو الأفضل؟
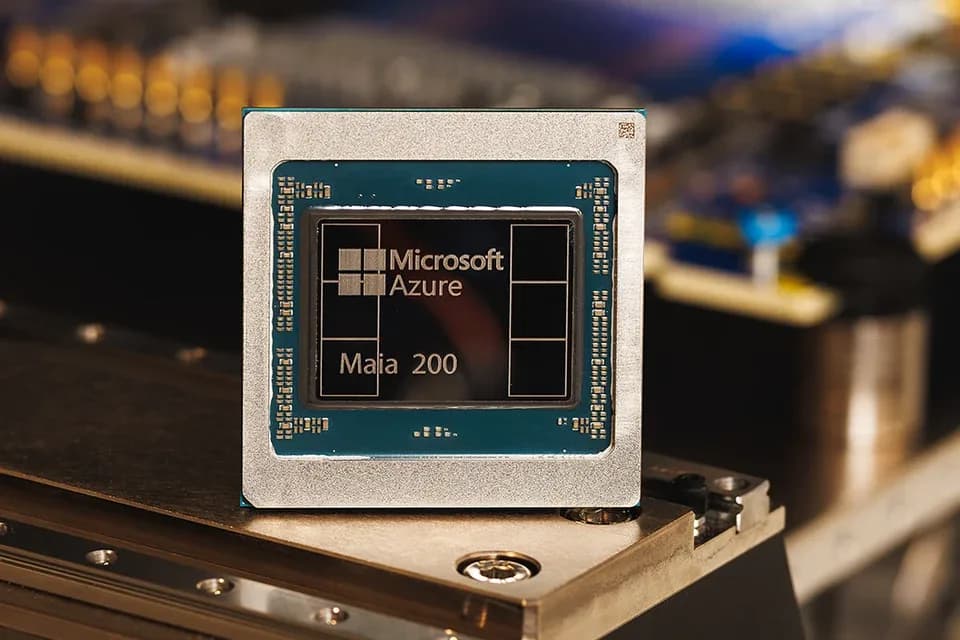
مصنوعة على TSMC 3 نانومتر مع 216 جيجابايت HBM3e و NIC إيثرنت مدمج بسرعة 2.8 تيرابايت/ثانية، توفر Maia 200 أداءً أفضل بنسبة 30% لكل دولار في Azure.
تجمع شريحة Maia 200 من Microsoft بين 216 جيجابايت من ذاكرة HBM3e و 272 ميجابايت من SRAM مع NIC إيثرنت مدمج في غلاف 750 واط. تتوسع بسلاسة إلى 6144 مسرعًا عبر شبكة إيثرنت قياسية.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي216 جيجابايت HBM3e (7 تيرابايت/ثانية) + 272 ميجابايت SRAMالحوسبة القصوى 10.1 بيتا عمليات FP45+ بيتا فلوبس FP8قابلية التوسع 2.8 تيرابايت/ثانية On-Die Ethernet ATL (6,144 شريحة)الشركة المصنعة والمعالجة Microsoft Azure (TSMC N3)Editorial Strengths & Watchouts
+ Strengths / Pros
- +ذاكرة HBM3e بسعة 216 جيجابايت و SRAM بسعة 272 ميجابايت في غلاف 750 واط
- +NIC مدمج بسرعة 2.8 تيرابايت/ثانية يتوسع إلى 6144 شريحة
− Watchouts / Trade-Offs
- −مقيدة بمناطق Microsoft Azure فقط
- −معمارية موجهة للاستدلال وليست شريحة تدريب تجارية
Eligibility & Access
- مثالية لـ Microsoft 365 Copilot و Azure AI Foundry
- مناسبة لمهام الاستدلال المتقدمة
Key Caveats to Verify
- الوصول مقصور على منصة Azure
- لا تتوفر كأجهزة مستقلة
Vote: هل تعتقد أن Maia 200 هو الأفضل؟
ربط 64 شريحة مخصصة من Annapurna عبر NeuronLink في خادم Ultra بسعة 6 تيرابايت HBM3، يرسخ Trainium2 نطاق Anthropic و Amazon Bedrock.
تجهز AWS Trainium2 كل خادم Trn2 بـ 16 شريحة، وتوسع NeuronLink عبر 64 شريحة في خوادم Trn2 UltraServers. توفر هذه الخوادم قوة حوسبة تبلغ 83.2 بيتا فلوبس و 6 تيرابايت من ذاكرة HBM3 المشتركة.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي96 جيجابايت HBM32.9 تيرابايت/ثانية لكل شريحة (6 تيرابايت خادم فائق)الحوسبة القصوى 1.3 بيتا فلوبس FP8 (83.2 بيتا فلوبس / خادم فائق بـ 64 شريحة)قابلية التوسع NeuronLink (64 شريحة) + 12.8 تيرابايت/ثانية EFAv3الشركة المصنعة والمعالجة #5AWS Annapurna LabsEditorial Strengths & Watchouts
+ Strengths / Pros
- +خوادم UltraServer بـ 64 شريحة تجمع 6 تيرابايت من HBM3 وعرض نطاق ترددي 185 تيرابايت/ثانية
- +شبكة EFAv3 بسرعة 12.8 تيرابايت/ثانية تتوسع إلى مجموعات بآلاف الشرائح
− Watchouts / Trade-Offs
- −يتطلب تجميع الرسوم البيانية والنواة المخصصة عبر AWS Neuron SDK
- −ذاكرة HBM3 بسعة 96 جيجابايت لكل شريحة تتخلف عن الشرائح الأحدث
Eligibility & Access
- مثالية لتدريب نماذج الأساس الأصلية لـ AWS
- مناسبة لمهام الاستدلال على نطاق واسع في Amazon Bedrock
Key Caveats to Verify
- تعتمد على AWS Neuron SDK
- سعة ذاكرة أقل لكل شريحة مقارنة بالمنافسين
Vote: هل تعتقد أن Trainium2 هو الأفضل؟
مع 141 جيجابايت من ذاكرة HBM3e بسرعة 4.8 تيرابايت/ثانية وخيارات PCIe مبردة بالهواء بقدرة 600 واط، تظل H200 ترقية أساسية لمراكز البيانات الحالية.
تعزز NVIDIA H200 بنية Hopper بذاكرة HBM3e بسعة 141 جيجابايت وعرض نطاق ترددي 4.8 تيرابايت/ثانية. توفر قوة حوسبة تقارب 4 بيتا فلوبس FP8 وتدعم NVLink رباعي الاتجاهات.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي141 جيجابايت HBM3e4.8 تيرابايت/ثانيةالحوسبة القصوى 3,958 تيرافلوبس FP8 / INT8 (SXM)قابلية التوسع 900 جيجابايت/ثانية NVLink 4 (SXM)1.8 تيرابايت/ثانية NVL رباعي الاتجاهاتالشركة المصنعة والمعالجة NVIDIA (TSMC 4N Hopper)Editorial Strengths & Watchouts
+ Strengths / Pros
- +توافق مباشر مع رفوف HGX H100 الحالية وخوادم PCIe مبردة بالهواء
- +تستوعب ذاكرة 141 جيجابايت نماذج 70 مليار معلمة بسهولة
− Watchouts / Trade-Offs
- −تفتقر إلى نوى Tensor FP4 المدمجة في Blackwell
- −نصف عرض النطاق الترددي للذاكرة مقارنة بالشرائح الرائدة
Eligibility & Access
- مثالية لتوسيع مجموعات الذكاء الاصطناعي المحلية المبردة بالهواء
- مناسبة للحاجة إلى سعة GPU متعددة السحابات الفورية
Key Caveats to Verify
- لا تدعم نوى FP4 المخصصة
- عرض نطاق ترددي أقل للذاكرة مقارنة بالجيل الأحدث
Vote: هل تعتقد أن H200 هو الأفضل؟
أربعة تريليونات ترانزستور و 900,000 نواة ذكاء اصطناعي عبر شريحة واحدة غير منقطعة بمساحة 46,225 مم² تطلق سرعات توكن SRAM بسعة بيتابايت في الثانية.
تزيل Cerebras WSE-3 حدود الرتوش بين الشرائح، وتدمج 4 تريليونات ترانزستور و 900,000 نواة ذكاء اصطناعي و 44 جيجابايت من SRAM على الشريحة. تصل إلى 21 بيتابايت/ثانية من عرض النطاق الترددي.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي44 جيجابايت On-Wafer SRAM21–43.2 بيتابايت/ثانيةالحوسبة القصوى 125 بيتا فلوبس (WSE-3)250 بيتا فلوبس (WSE-3 Turbo)قابلية التوسع شريحة واحدة بمساحة 46,225 مم² (53.5 بيتابايت/ثانية On-Wafer Fabric)الشركة المصنعة والمعالجة Cerebras Systems (TSMC 5 نانومتر Wafer)Editorial Strengths & Watchouts
+ Strengths / Pros
- +عرض نطاق ترددي SRAM على الشريحة يصل إلى 43.2 بيتابايت/ثانية يزيل اختناقات الذاكرة الخارجية
- +نموذج برمجة أحادي الجهاز يتجنب تصحيح أخطاء GPU المعقد
− Watchouts / Trade-Offs
- −تتطلب ذاكرة SRAM بسعة 44 جيجابايت تجميع أنظمة متعددة أو تدفق أوزان لنماذج متطورة
- −بصمة جهاز CS-3 / CS-4 مملوكة وليست شفرات خادم قياسية
Eligibility & Access
- مثالية للاستدلال فائق السرعة
- مناسبة لخطوط أنابيب فك التشفير المنفصلة
Key Caveats to Verify
- سعة ذاكرة محدودة على الشريحة تتطلب تجميع أنظمة متعددة
- تعتمد على أجهزة Cerebras الخاصة
Vote: هل تعتقد أن WSE-3 هو الأفضل؟
الجدولة الحتمية وقت الترجمة وعرض النطاق الترددي SRAM على الشريحة البالغ 80-150 تيرابايت/ثانية جعلت LPU معيارًا زمن الاستجابة للذكاء الاصطناعي الصوتي والوكيل …
تم تصميم Groq LPU بجدولة وقت الترجمة، وتوفر 230 ميجابايت من SRAM بسرعة 80 تيرابايت/ثانية. تتوسع إلى 500 ميجابايت بسرعة 150 تيرابايت/ثانية لكل شريحة في وحدات LPX بـ 256 شريحة.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي230 ميجابايت–500 ميجابايت On-Chip SRAM80–150 تيرابايت/ثانيةالحوسبة القصوى #8جدولة وقت الترجمة الحتمية للموتر/المتجهقابلية التوسع شريحة إلى شريحة / بود LPX بـ 256 LPUالشركة المصنعة والمعالجة #8Editorial Strengths & Watchouts
+ Strengths / Pros
- +تضمن الجدولة الحتمية وقت الترجمة زمن استجابة أقل من ميلي ثانية
- +عرض النطاق الترددي الداخلي SRAM يسحق زمن استجابة فك التشفير المنخفض
− Watchouts / Trade-Offs
- −تتطلب ذاكرة SRAM الصغيرة لكل شريحة مئات من وحدات LPU لحمل نموذج كبير
- −محرك استدلال بحت بدون قدرات تدريب نماذج أساسية
Eligibility & Access
- مثالية للذكاء الاصطناعي الصوتي والوكيل في الوقت الفعلي
- مناسبة لمهام الاستدلال ذات زمن الاستجابة المنخفض للغاية
Key Caveats to Verify
- سعة ذاكرة صغيرة جدًا لكل شريحة
- غير مناسبة لتدريب نماذج الذكاء الاصطناعي
Vote: هل تعتقد أن LPU هو الأفضل؟
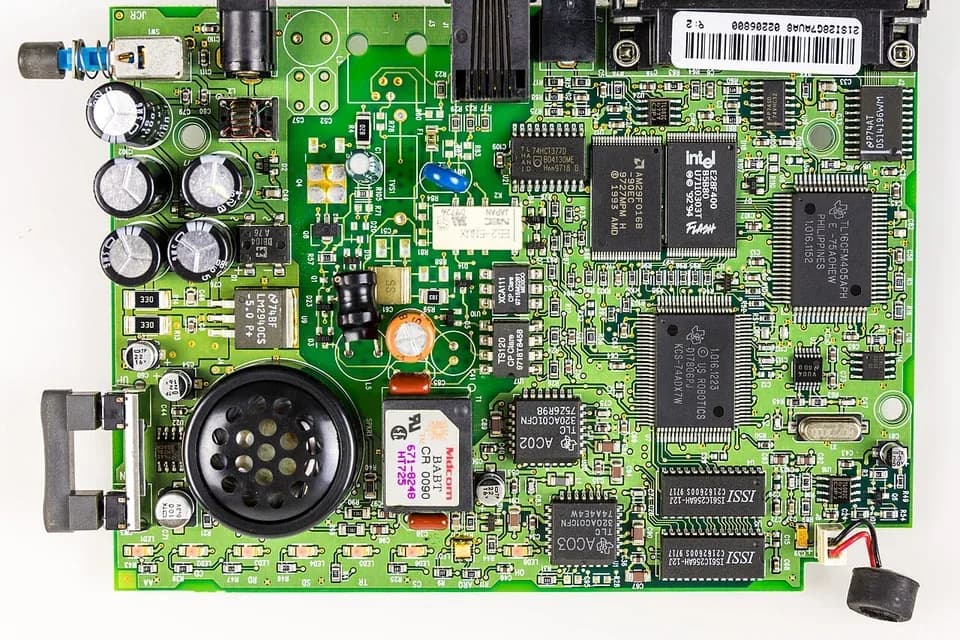
دمج 24 منفذ NIC RoCEv2 بسرعة 200 جيجابت/ثانية مباشرة على حزمة HBM2e بسعة 128 جيجابايت بدقة 5 نانومتر يوفر توسع ذكاء اصطناعي عبر الإيثرنت المفتوح دون مفاتيح خ…
بنيت Intel Gaudi 3 على TSMC 5 نانومتر، وتجمع بين ثمانية محركات ضرب مصفوفة، وذاكرة HBM2e بسعة 128 جيجابايت، و 24 منفذ RoCEv2 مدمج بسرعة 200 جيجابت/ثانية.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي128 جيجابايت HBM2e + 96 ميجابايت SRAM3.7 تيرابايت/ثانيةالحوسبة القصوى 1.8 بيتا فلوبس FP8 و BF16قابلية التوسع 24 × 200 جيجابت/ثانية RoCEv2 Ethernet مدمجالشركة المصنعة والمعالجة Intel / Habana Labs (TSMC 5 نانومتر)Editorial Strengths & Watchouts
+ Strengths / Pros
- +منافذ 200GbE RoCEv2 المدمجة تلغي ضرائب مفاتيح الشبكة الخاصة
- +بطاقات PCIe HL-338 بقدرة 600 واط تناسب خوادم Xeon القياسية
− Watchouts / Trade-Offs
- −عرض النطاق الترددي HBM2e (3.7 تيرابايت/ثانية) و FP8 يتخلفان عن الشرائح الرائدة
- −مجتمع مطوري نواة تابعين أصغر مقارنة بـ CUDA أو ROCm
Eligibility & Access
- مثالية للمؤسسات ذات الميزانية المحدودة لـ RAG والضبط الدقيق
- مناسبة للمستخدمين الذين يبحثون عن بديل مفتوح لشبكات InfiniBand
Key Caveats to Verify
- عرض نطاق ترددي أقل للذاكرة مقارنة بالجيل الأحدث
- اعتماد أقل على مجتمع المطورين الخارجيين
Vote: هل تعتقد أن Gaudi 3 هو الأفضل؟
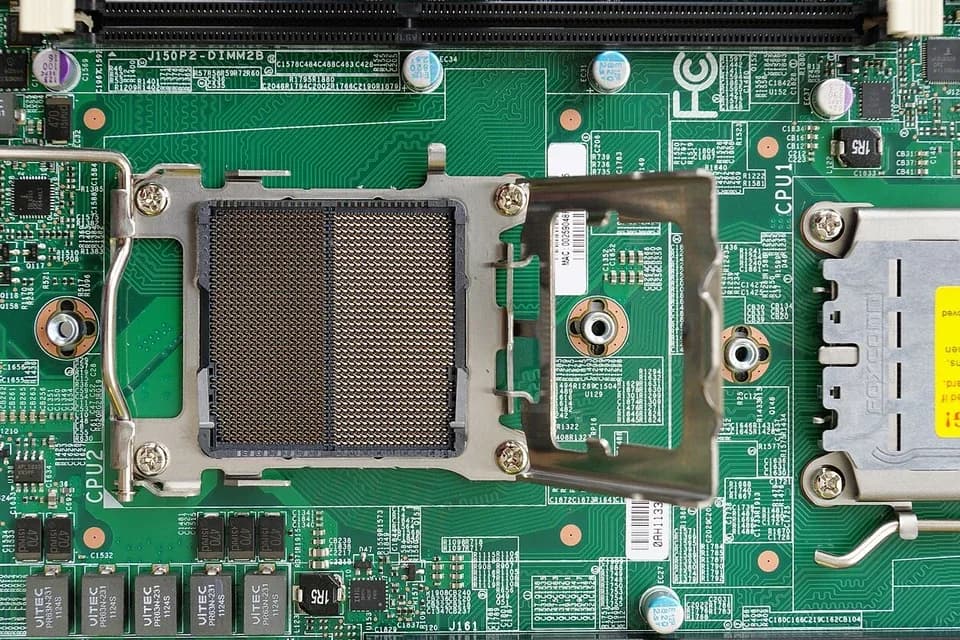
تعمل MTIA v2 بكفاءة 90 واط فقط على TSMC 5 نانومتر مع مترجم Triton-MTIA PyTorch 2، وتثبت أن السيليكون المخصص 8x8 PE يمكن أن يقلل من طاقة التصنيف الفائقة.
تم تصميم MTIA v2 من Meta لأسطولها الضخم من أنظمة التوصية والتصنيف والاستدلال. توفر 708 تيرافلوبس INT8 (متفرقة) و 256 ميجابايت من SRAM بسرعة 2.7 تيرابايت/ثانية، مع استهلاك طاقة منخفض يبلغ 90 واط.
Key Benchmarks & Specifications
الذاكرة وعرض النطاق الترددي256 ميجابايت On-Chip SRAM (2.7 تيرابايت/ثانية) + 128 جيجابايت LPDDR5الحوسبة القصوى 708 تيرافلوبس INT8 (متفرقة)354 تيرافلوبس BF16قابلية التوسع شبكة PCIe Gen5 + RDMA Scale-Out (بود 72 شريحة)الشركة المصنعة والمعالجة Meta Infrastructure (TSMC 5 نانومتر)Editorial Strengths & Watchouts
+ Strengths / Pros
- +كفاءة استهلاك طاقة فائقة تبلغ 90 واط تتيح 72 مسرعًا في رف واحد
- +مترجم Triton-MTIA يتكامل مباشرة مع PyTorch 2 TorchInductor
− Watchouts / Trade-Offs
- −سيليكون مراكز بيانات Meta الداخلي غير متاح للعملاء الخارجيين
- −يستهدف LPDDR5 خارج الشريحة التصنيف DLRM والاستدلال المتوسط
Eligibility & Access
- مثالية لكفاءة الطاقة في مراكز البيانات
- مناسبة لمهام التصنيف والتوصية
Key Caveats to Verify
- غير متاح للعملاء الخارجيين
- سعة ذاكرة خارجية محدودة
Vote: هل تعتقد أن MTIA v2 هو الأفضل؟
Have a list idea?
Start your own list and get help drafting entries with AI. A free account is required.
Create a list with AI →Think something was robbed of a spot?
Nominate a missing contender — once approved, the community votes it up or down into the rankings.
منهجية التصنيف ومعايير المقارنة
يتم تقييم كل مسرع بناءً على أربعة عوامل رئيسية: عرض النطاق الترددي للحوسبة والذاكرة، وقابلية التوسع في تجميعات كبيرة، ونضج النظام البيئي البرمجي، والأداء مقابل السعر أو استهلاك الطاقة. يتم تحديث التصنيف باستمرار بناءً على أحدث البيانات الفنية ونتائج اختبارات الأداء. نحن نؤمن بقوة المجتمع، لذا فإن تصويتاتكم تلعب دورًا حيويًا في تشكيل هذا التصنيف. كل صوت يساهم في تحديد الأفضل في عالم مسرعات الذكاء الاصطناعي، مما يضمن أن يظل التصنيف محدثًا ويعكس الإجماع الجماعي.
Image credits
- NVIDIA Blackwell B200 و GB200 NVL72: youtube.com
- Google Cloud TPU v6e (Trillium): Visitor7 (CC BY-SA 3.0)
- AMD Instinct MI355X: Festival Internacional de Cine en Guadalajara (CC BY 2.0)
- Microsoft Azure Maia 200: Microsoft Azure (TSMC N3) Official Hardware Press Release
- AWS Trainium2 (EC2 Trn2 UltraServer): pinterest.com
- NVIDIA H200 Tensor Core GPU: x.com
- Cerebras Wafer-Scale Engine 3 (WSE-3 / WSE-3T): best-wallpaper.net
- Groq LPU و NVIDIA Groq 3 LPX: alfred.com
- Intel Gaudi 3 AI Accelerator: Raimond Spekking (CC BY-SA 4.0)
- Meta Next-Gen MTIA v2: smial (talk) (FAL)
Rank it your way
Remix this list into your own ranking, or head to the play hub for every game mode and community breakdown — blind mode, challenges, tier lists, and more.