Verified MethodologyPrimary Evidence 45% · Comparative Specs 30% · Community Consensus 25%
Top 10 AI Datacenter Chips and Accelerators 2026 Zh Hant
Remixed from NVIDIA Blackwell vs. Google TPU v6e? Top 10 AI Datacenter Chips & Accelerators in 2026 by @admin
2026年,前沿人工智能基礎設施的競賽已進入白熱化階段。NVIDIA Blackwell 系列與 Google Cloud TPU v6e 等巨頭持續推動技術邊界,同時 AMD、Microsoft 及 Cerebras…
Read more
等亦帶來創新產品。我們綜合評估了算力與記憶體頻寬、叢集擴展架構、軟件生態成熟度及性價比,為您呈獻2026年全球十大AI數據中心晶片與加速器排名,助您掌握未來趨勢。
Top10Grid Editorial Studio

Starting order. Vote up or down to reorder this list.
Current Rankings
- #1 Top RankedLeader
結合雙晶片設計與72 GPU NVLink 5架構,Blackwell成為前沿AI工廠的基準。
NVIDIA Blackwell採用雙4NP製程晶片,透過10 TB/s NV-HBI連接,提供高達288 GB HBM3e記憶體。GB200 NVL72機架整合72個GPU,形成單一龐大的130 TB/s記憶體協同加速器。
Key Benchmarks & Specifications
記憶體與頻寬180–288 GB HBM3e8.0 TB/s. 峰值算力 9 PFLOPS FP815–18 PFLOPS FP4. 擴展架構 1.8 TB/s NVLink 5 (72-GPU 領域). 製造商與製程 NVIDIA (TSMC 4NP)Editorial Strengths & Watchouts
+ Strengths / Pros
- +72 GPU NVLink 5協同
- +極高HBM3e容量與頻寬
− Watchouts / Trade-Offs
- −GB200 NVL72需液冷
- −初期資本支出高昂
Eligibility & Access
- 適用於前沿LLM預訓練
- 大規模MoE推理叢集
Key Caveats to Verify
- 高功率密度需求
- 長企業採購週期
Vote: 您認為NVIDIA Blackwell系列是否應穩居榜首?
Google第六代Trillium TPU提供4.7倍峰值算力,擴展效率高達99%。
Cloud TPU v6e (Trillium)為Google的AI Hypercomputer堆疊而生,每顆晶片提供918 TFLOPS的BF16/FP8算力及1,638 GB/s HBM頻寬,並能擴展至256顆晶片的2D環狀架構。
Key Benchmarks & Specifications
記憶體與頻寬32 GB HBM1,638 GB/s (每晶片). 峰值算力 918 TFLOPS BF16/FP81,836 TOPS INT8. 擴展架構 800 GB/s ICI256-晶片 2D環狀叢集. 製造商與製程 #2Google Cloud 自研晶片Editorial Strengths & Watchouts
+ Strengths / Pros
- +多叢集擴展效率達99%
- +LLM訓練性價比高
− Watchouts / Trade-Offs
- −僅限Google Cloud使用
- −HBM容量相對較小
Eligibility & Access
- 適合JAX、PyTorch/XLA團隊
- 優化雲端訓練與服務
Key Caveats to Verify
- 無本地硬件銷售
- 需較早進行張量分片
Vote: 您認為Google Cloud TPU v6e的雲端專屬策略是否影響其排名?
基於3nm CDNA 4,MI355X是開放生態系統對NVIDIA Blackwell的主要競爭者。
AMD Instinct MI355X採用TSMC 3nm製程,配備288 GB HBM3e記憶體(8 TB/s頻寬)及原生MXFP4/MXFP6引擎,8 GPU OAM基板可匯集2.3 TB協同HBM3e。
Key Benchmarks & Specifications
記憶體與頻寬288 GB HBM3e8.0 TB/s. 峰值算力 10.1 PFLOPS MXFP4 & MXFP6. 擴展架構 7× Infinity Fabric 連結 (8 GPU OAM). 製造商與製程 AMD (TSMC 3nm / 6nm CDNA 4)Editorial Strengths & Watchouts
+ Strengths / Pros
- +龐大的HBM3e容量
- +開放ROCm生態系統
− Watchouts / Trade-Offs
- −Infinity Fabric僅限8 GPU
- −散熱需求高
Eligibility & Access
- 適用於超大規模雲端
- 企業級AI部署
Key Caveats to Verify
- 需高密度散熱
- 擴展架構受限
Vote: 您認為AMD Instinct MI355X的開放性是否優於封閉生態系統?
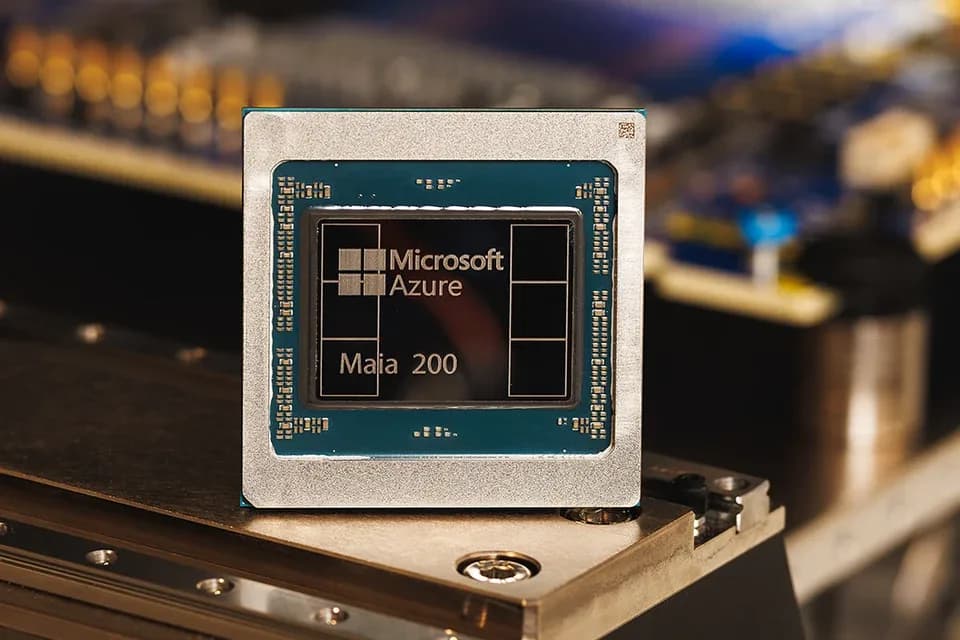
Maia 200採用3nm製程,整合2.8 TB/s以太網NIC,性價比高。
Microsoft Azure Maia 200採用TSMC N3製程,提供10.1 PetaOPS FP4算力,整合216 GB HBM3e記憶體及272 MB SRAM,並內建以太網AI傳輸層NIC,可擴展至6,144個加速器。
Key Benchmarks & Specifications
記憶體與頻寬216 GB HBM3e (7 TB/s) + 272 MB SRAM. 峰值算力 10.1 PetaOPS FP45+ PFLOPS FP8. 擴展架構 2.8 TB/s 片上以太網ATL (6,144 晶片). 製造商與製程 Microsoft Azure (TSMC N3)Editorial Strengths & Watchouts
+ Strengths / Pros
- +高HBM3e容量與低功耗
- +整合式以太網NIC
− Watchouts / Trade-Offs
- −僅限Azure使用
- −推論優先架構
Eligibility & Access
- 適用於Azure雲端
- 推理與代理任務
Key Caveats to Verify
- SDK推廣階段
- 非通用訓練晶片
Vote: 您認為Maia 200的雲端專屬策略會限制其發展嗎?
Trn2 UltraServer整合64顆晶片,提供6 TB HBM3及185 TB/s頻寬。
AWS Trainium2為第二代加速器,Trn2實例配備16顆晶片,Trn2 UltraServers則透過NeuronLink擴展至64顆晶片,提供83.2 PFLOPS FP8算力、6 TB共享HBM3及185 TB/s總記憶體頻寬。
Key Benchmarks & Specifications
記憶體與頻寬96 GB HBM32.9 TB/s (每晶片). 峰值算力 1.3 PFLOPS FP8 (83.2 PFLOPS / 64-晶片). 擴展架構 NeuronLink (64 晶片) + 12.8 Tbps EFAv3. 製造商與製程 #5AWS Annapurna LabsEditorial Strengths & Watchouts
+ Strengths / Pros
- +64-晶片UltraServer架構
- +高擴展性網路
− Watchouts / Trade-Offs
- −需透過Neuron SDK編譯
- −HBM容量不及新一代
Eligibility & Access
- 適用於AWS原生模型
- 大規模訓練任務
Key Caveats to Verify
- 非CUDA生態
- HBM容量限制
Vote: 您認為AWS Trainium2的專有生態系統是其優勢還是劣勢?
H200提供141 GB HBM3e,是現有數據中心升級的理想選擇。
NVIDIA H200在Hopper架構基礎上,配備141 GB HBM3e記憶體(4.8 TB/s),提供近4 PFLOPS FP8算力,支援4路NVLink,適用於600W風冷PCIe NVL伺服器。
Key Benchmarks & Specifications
記憶體與頻寬141 GB HBM3e4.8 TB/s. 峰值算力 3,958 TFLOPS FP8 / INT8 (SXM). 擴展架構 900 GB/s NVLink 4 (SXM)1.8 TB/s 4路NVL. 製造商與製程 NVIDIA (TSMC 4N Hopper)Editorial Strengths & Watchouts
+ Strengths / Pros
- +兼容現有HGX H100機架
- +LLM推理速度顯著提升
− Watchouts / Trade-Offs
- −缺乏FP4 Tensor核心
- −記憶體頻寬不及新旗艦
Eligibility & Access
- 適用於企業風冷部署
- 多雲GPU容量擴充
Key Caveats to Verify
- 無FP4硬體支援
- 頻寬不及最新HBM3e
Vote: 您認為H200的升級優勢是否足以彌補其技術上的不足?
WSE-3將4兆個電晶體整合於單一晶圓,提供PB級SRAM頻寬。
Cerebras WSE-3採用單一46,225 mm²晶圓設計,整合4兆個電晶體、900,000個AI核心及44 GB片上SRAM,提供21 PB/s頻寬(WSE-3 Turbo版本提升至43.2 PB/s)。
Key Benchmarks & Specifications
記憶體與頻寬44 GB 片上SRAM21–43.2 PB/s. 峰值算力 125 PFLOPS (WSE-3)250 PFLOPS (WSE-3 Turbo). 擴展架構 單一46,225 mm²晶片 (53.5 PB/s 片上架構). 製造商與製程 Cerebras Systems (TSMC 5nm 晶圓)Editorial Strengths & Watchouts
+ Strengths / Pros
- +極高的SRAM頻寬
- +簡化的編程模型
− Watchouts / Trade-Offs
- −SRAM容量限制
- −專有系統架構
Eligibility & Access
- 適用於超高速推理
- 分層式AI架構
Key Caveats to Verify
- 大型模型需叢集
- 非標準伺服器外形
Vote: 您認為Cerebras的晶圓級架構是未來AI晶片的發展方向嗎?
Groq LPU的確定性執行與高頻寬SRAM,樹立了低延遲AI的標竿。
Groq的語言處理單元(LPU)採用編譯器優先設計,提供230 MB(LPU v1)至500 MB(Groq 3 LPX)的片上SRAM,頻寬高達80–150 TB/s,專為低延遲推論設計。
Key Benchmarks & Specifications
記憶體與頻寬230 MB–500 MB 片上SRAM80–150 TB/s. 峰值算力 #8確定性編譯調度張量/向量. 擴展架構 晶片間準同步 / 256-LPU LPX 機架. 製造商與製程 #8Groq / NVIDIA LPX 合作夥伴生態Editorial Strengths & Watchouts
+ Strengths / Pros
- +確定性低延遲
- +高片上SRAM頻寬
− Watchouts / Trade-Offs
- −SRAM容量小
- −僅限推論
Eligibility & Access
- 適用於實時語音AI
- 代理式AI應用
Key Caveats to Verify
- 單晶片記憶體容量小
- 無訓練能力
Vote: 您認為Groq LPU的確定性架構是AI推論的未來嗎?
Gaudi 3整合24個200GbE NIC,提供開放以太網擴展。
Intel Gaudi 3採用TSMC 5nm製程,配備128 GB HBM2e記憶體(3.7 TB/s)及24個整合式200GbE RoCEv2連接埠,提供1.8 PFLOPS FP8/BF16算力。
Key Benchmarks & Specifications
記憶體與頻寬128 GB HBM2e + 96 MB SRAM3.7 TB/s. 峰值算力 1.8 PFLOPS FP8 & BF16. 擴展架構 24× 200GbE 整合式RoCEv2以太網. 製造商與製程 Intel / Habana Labs (TSMC 5nm)Editorial Strengths & Watchouts
+ Strengths / Pros
- +整合式以太網擴展
- +支援標準PCIe卡
− Watchouts / Trade-Offs
- −HBM2e頻寬較低
- −第三方開發者社群較小
Eligibility & Access
- 適用於成本敏感型企業
- RAG與微調任務
Key Caveats to Verify
- 頻寬不及HBM3e
- 生態系統相對封閉
Vote: 您認為Gaudi 3的開放以太網策略能否吸引更多企業用戶?
MTIA v2以90W TDP實現高效率,專為Meta的推薦與推論任務設計。
Meta Next-Gen MTIA v2專為Meta的大規模推薦、排名和推論任務設計,採用TSMC 5nm製程,提供708 TFLOPS INT8算力、256 MB片上SRAM及128 GB LPDDR5,TDP僅90W。
Key Benchmarks & Specifications
記憶體與頻寬256 MB 片上SRAM (2.7 TB/s) + 128 GB LPDDR5. 峰值算力 708 TFLOPS INT8 (稀疏)354 TFLOPS BF16. 擴展架構 PCIe Gen5 Mesh + RDMA擴展 (72-晶片機架). 製造商與製程 Meta基礎設施 (TSMC 5nm)Editorial Strengths & Watchouts
+ Strengths / Pros
- +超高能效比
- +緊湊機架設計
− Watchouts / Trade-Offs
- −僅限Meta內部使用
- −LPDDR5頻寬有限
Eligibility & Access
- 適用於Meta內部推薦系統
- 低功耗推論任務
Key Caveats to Verify
- 無外部銷售
- 離片頻寬限制
Vote: 您認為Meta的自研晶片策略是否會影響其在行業內的領導地位?
Have a list idea?
Start your own list and get help drafting entries with AI. A free account is required.
Create a list with AI →Think something was robbed of a spot?
Nominate a missing contender — once approved, the community votes it up or down into the rankings.
排名方法與評選標準
我們的評選標準涵蓋四大核心領域:算力與記憶體頻寬(佔35%)、叢集擴展架構(佔25%)、軟件堆疊與生態系統成熟度(佔25%),以及性價比/每瓦效能(佔15%)。我們深入分析各款晶片的技術規格、實際應用表現及市場潛力。 讀者投票亦是排名演變的重要一環。透過您的參與,我們能更精準地反映市場的真實需求與偏好,讓排名更具參考價值。立即投票,影響您心目中的頂尖AI晶片。
Image credits
- NVIDIA Blackwell B200 及 GB200 NVL72: amazon.com
- Google Cloud TPU v6e (Trillium): Visitor7 (CC BY-SA 3.0)
- AMD Instinct MI355X: Festival Internacional de Cine en Guadalajara (CC BY 2.0)
- Microsoft Azure Maia 200: Microsoft Azure (TSMC N3) Official Hardware Press Release
- AWS Trainium2 (EC2 Trn2 UltraServer): amazon.co.uk
- NVIDIA H200 Tensor Core GPU: wallpapers-clan.com
- Cerebras Wafer-Scale Engine 3 (WSE-3 / WSE-3T): storage.googleapis.com
- Groq LPU 及 NVIDIA Groq 3 LPX: design.udlvirtual.edu.pe
- Intel Gaudi 3 AI Accelerator: Raimond Spekking (CC BY-SA 4.0)
- Meta Next-Gen MTIA v2: smial (talk) (FAL)
Rank it your way
Remix this list into your own ranking, or head to the play hub for every game mode and community breakdown — blind mode, challenges, tier lists, and more.